

NVIDIAへの依存度を低減、中国国産TPUが新たな代替案に
11月28日‐『サウスチャイナ・モーニング・ポスト』によると、現在各国のクラウド・AI企業はNVIDIA製AI GPUへの過度な依存を軽減するため、多様なハードウェアソリューションの模索を加速している。グーグルがMetaに自社開発TPUを供給する計画を発表したことで、TPUエコシステムの発展が間近に迫っている。中国の人工知能(AI)チップスタートアップ企業である中昊芯英(Zhonghao Xinying(Hangzhou)Technology Co., Ltd.)が独自開発したTPUも、中国が自国AI演算能力を推進する新たな道筋となることが期待されている。
資料によると、中昊芯英は2019年に設立され、主要な創業チーム及びコア開発チームはGoogle、Oracle、Facebook、Microsoft、Samsung、HiSiliconなどの大手企業出身の経験豊富なAIソフトウェア・ハードウェア設計専門家で構成されている。創業者の楊龔軼凡(ヤン・ゴンイファン)氏はGoogle TPU v2、v3、v4のコアアーキテクチャ開発に携わった経歴を持つ。同社の主力製品は、超大規模AIモデルトレニンーグを支える高性能AIチップと計算クラスターであり、完全なソフトウェア・ハードウェア統合ソリューションを構築。生産変革能力を備えたAI革新的技術ソリューションをグローバル顧客に提供し、AIのエンジニアリング実装と産業化プロセスを加速している。
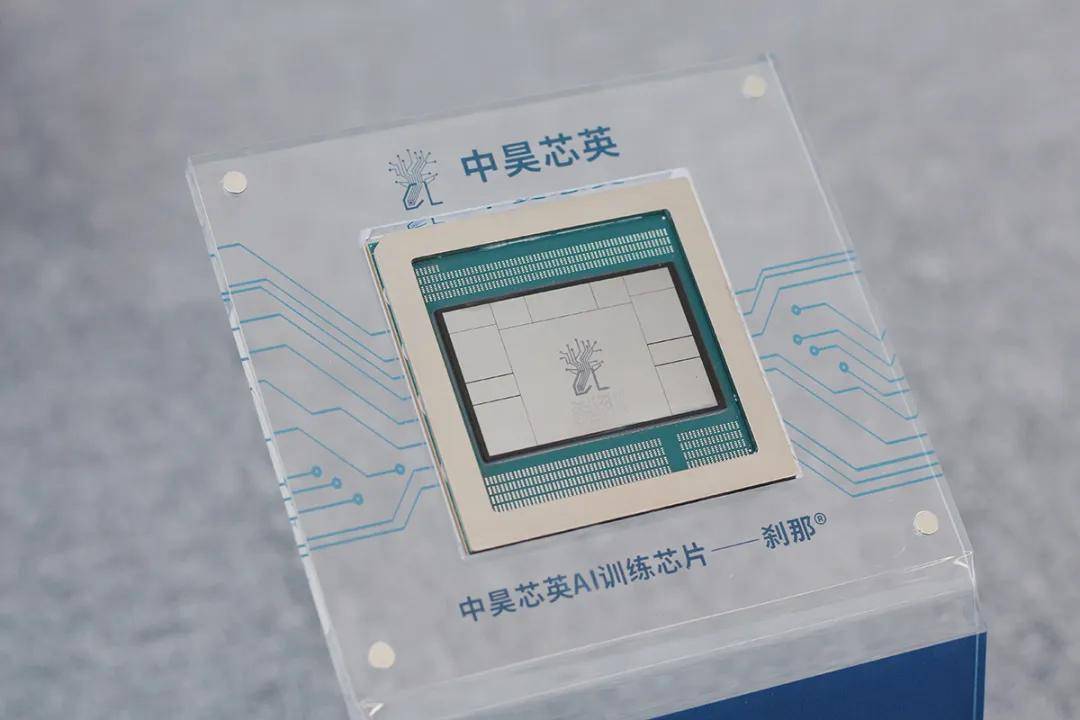
2023年、中昊芯英は完全自社開発のAIトレニンーグ専用の高性能TPUトレニンーグチップ「刹那(Chana)」の量産出荷に成功した。このチップは12nmプロセスを基盤とし、完全自主制御のIPコア、完全自社開発の命令セットと計算プラットフォームを備え、計算性能はNvidia A100の最大1.5倍に達する。類似の大規模モデル負荷下では消費電力が30%低減され、単位演算能力コストは同類の海外チップの約42%であり、性能・消費電力・コストの三面で明らかな優位性を示している。
中昊芯英はトレニンーグチップ「刹那」を基盤に、AIサーバー「泰則(Taize)」を構築。さらに1024枚のチップ間を効率的に接続し、1000億パラメータを超える大規模モデルのトレーニングと推論を支える「泰則」大規模AI計算クラスターシステムを実現した。全体の演算能力は200Pを突破し、兆単位パラメータモデルのトレーニング需要に対応可能だ。超高AI演算性能と超低消費電力という強みを活かし、2023年末には青海省「シルククラウドバレー」低炭素演算産業パークから9億元(約198億円)超の調達受注を獲得。エネルギー、教育、製造など多分野で進展を遂げ、収益化を実現した。
今年9月、中昊芯英は天普股份( NINGBO TIP RUBBER TECHNOLOGY CO.,LTD)に対し全面的なテンダー・オファーを提案し、テンダー・オファー価格は23.98元/株で、上場会社の25%株式を取得する計画である。最終的に、中昊芯英の創業者である楊龔軼凡氏は、中昊芯英と海南芯繁(Hainan Xinfan Enterprise Management Partnership (Limited Partnership))を通じて上場会社の新たな実質支配者となる見込みである。
天普股份の公告によると、中昊芯英の2024年営業収入は5.98億元(約131.56億円)、純利益は8891万元(約19.56億円)であったが、2025年上半期の収入はわずか1.02億元(約22.44億円)、純損失は1.43億元(約31.46億円)となった。
(為替換算レート:1人民元=22円で計算)
(原文:https://www.icsmart.cn/99132/)