

Day-0対応を実現|摩爾線程(Moore Threads)、MiniMax M2.7大規模モデルへの最適化を最速で完了
4月12日、摩爾線程(Moore Threads)は、同社のフラッグシップ製品であるAI学習・推論統合型フルファンクションGPU「MTT S5000」において、次世代大規模モデル「MiniMax M2.7」へのDay-0対応を完了したと発表した。中国国産フルファンクションGPUが最先端AIモデルに対して示す迅速な適応力と安定した支援能力が、改めて裏付けられた形だ。
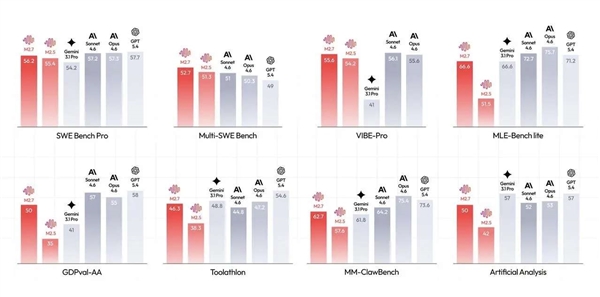
図:MTT S5000上で動作するMiniMax M2.7
MiniMax M2.7は、業界で初めて深層自己進化能力を備えた大規模モデルだ。自律的に「Agent Harness」を構築し、エージェントチームの連携、複雑なスキル呼び出し、ツール検索エンジンなどを駆使して高度な生産性タスクを遂行する。さらには、モデル自身の進化プロセスにも深く関与する点が特徴だ。ソフトウェアエンジニアリング分野では、エンドツーエンドのプロジェクト納品、ログ解析による障害対応、コードセキュリティレビュー、機械学習タスクまでをカバーする。プロフェッショナル向けオフィス環境では、Excel・PPT・Wordの高忠実度編集と多段階修正への対応力が飛躍的に向上しており、超長文脈の複雑なタスクにおいても、スキル追従率は安定して高い水準を維持する。その一方で、長文コンテキストの処理、複雑なエージェントタスクのスケジューリング、高忠実度編集といった用途は、計算効率に対して極めて厳しい要求を課すことになる。
MooreThreadの技術チームは、こうした要求に応えるため、自社アーキテクチャ「MUSA」に基づく徹底的なチューニングを実施。MTT S5000上でM2.7大規模モデルの高性能推論を実現した。その中核をなす技術的優位性は以下のとおりである。
▼超長文コンテキストに対応する高スループット
MTT S5000が備える80GBの大容量メモリ、1.6TB/sの高メモリ帯域幅、およびPD分離アーキテクチャを活用し、効率的なKVキャッシュ管理を組み合わせることで、MiniMax M2.7の長時間・多段階タスクを安定稼働させる。
▼全精度エンドツーエンド対応
MTT S5000はFP8からFP64までの全精度演算にネイティブで対応する。コード生成や金融モデリングなど、混合精度あるいは高精度演算が求められる場面においても、精度の高い信頼性ある判断を下すことが可能となる。
▼高演算性能と低遅延推論の両立
MTT S5000は、1基あたり1000 TFLOPS(FP16 Dense)の演算性能を誇る。vLLM-MUSAによるカスタムチューニングを施すことで、複雑なAgent Harnessの処理や高頻度のツール呼び出しが発生する状況下でも、遅延の少ない応答を実現する。
▼強固なエコシステム互換性
PyTorch、vLLM、SGLang、Tritonといった主要フレームワークと深く互換する。MUSA C++、Triton-MUSA、TileLang-MUSAといった抽象化レイヤーを経由することで、新たな演算子を事実上「ゼロコスト」で移行可能であり、最先端モデルの発表当日に迅速な最適化が完了する。
今回のDay-0対応は、MooreThreadの常態化された技術対応能力を改めて示す好例と言える。MUSAアーキテクチャによる主要AIエコシステムへの深い互換性と継続的な進化を基盤として、中国国産フル機能GPUコンピューティング基盤は、最先端モデルをカバーする「超高速適応・高効率デプロイ」の全プロセス支援体制を確立した。これにより、開発者はより迅速な対応、より安定した運用、より低い移行コストで最新モデルの機能をいち早く導入できる。大規模モデルのイノベーション実装と本格普及を、この計算基盤が加速させていくことは間違いない。
(原文:https://www.icsmart.cn/103768/)