

中国半導体企業「芯原微電子(VeriSilicon)」、NPU/GPGPU IPからSoCまでワンストップのロボットブレインAIソリューションを提供
7月3日、「VeriSilicon エンボディードAI専門技術セミナー」において、中国半導体の回路設計図(IP)プロバイダー「芯原微電子(VeriSilicon)」のGPU/NPU製品上級副社長である張慧明(ジャン・フィーミン)氏は、「ロボットのブレイン:高効率かつ強力なAIコンピューティングプロセッサ」をテーマに、VeriSiliconのAIコンピューティングプロセッサ分野における技術戦略を体系的に紹介した。張氏は、VeriSiliconが顧客向けにワンストップのロボットブレインAIソリューションを提供可能で、新たに発表したCC10000シリーズGPGPU IPは、大規模なAI演算能力を必要とするロボットやエッジサーバー製品に適しており、複数のパートナーとともに当該IPの製品化を推進していると指摘した。
NPUとGPGPUの二本柱戦略
ロボットは複雑なシステムで、複雑な知覚、判断、およびインタラクションを処理する必要があり、その中核となるのは高性能なAIプロセッサ、すなわち「ロボットブレイン」である。張氏は、「VeriSiliconがNPUおよびGPGPUベースのAI IPソリューションを提供可能で、設計サービスチームと連携してAI SoCトータルソリューションを提供する」と述べた。
VeriSiliconのNPUおよびGPGPUは長年の開発経験を持ち、第1世代のグラフィックスカードから、2016年のNPU拡張命令セット、そして2017年の初代NPU IPの発表に至るまで、VeriSiliconのGPU関連技術は約20年の蓄積があり、NPUも約10年の経験を持っている。VeriSiliconは一貫して統一されたアーキテクチャ戦略、つまり統一ソフトウェアソリューションと統一ハードウェアソリューションを推進している。
VeriSiliconのNPUとGPGPUの本質的な違いは演算能力の配分にある。NPUはTensor(テンソル)処理能力が大きく、一方GPGPUはVector(ベクトル)処理能力がTensorと同等で、VectorとTensorの協調処理が可能だ。
VIP9X00シリーズNPU IPが全面的にアップグレード
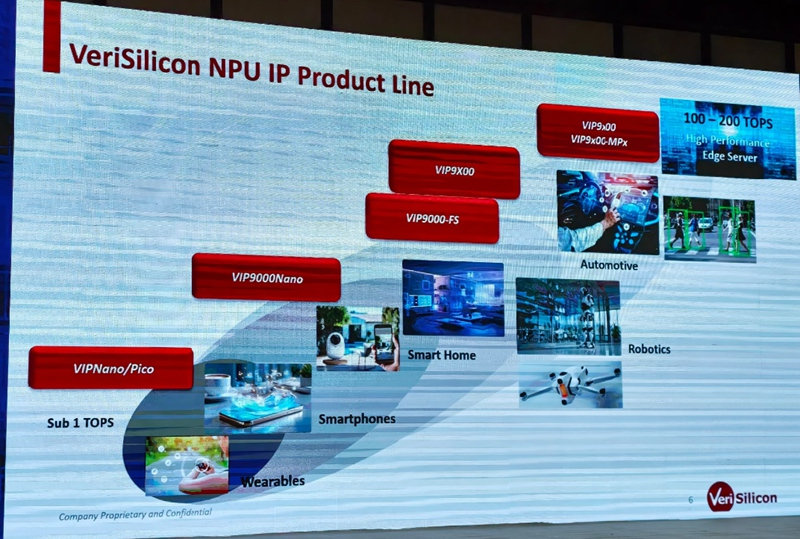
VeriSiliconのNPU IP製品シリーズには、VIP Nanoシリーズ、VIP9000-FSシリーズ、VIP9X00シリーズなどが含まれ、1TOPS未満から数百TOPSまでをカバーし、異なる性能レベルのニーズに対応できる。
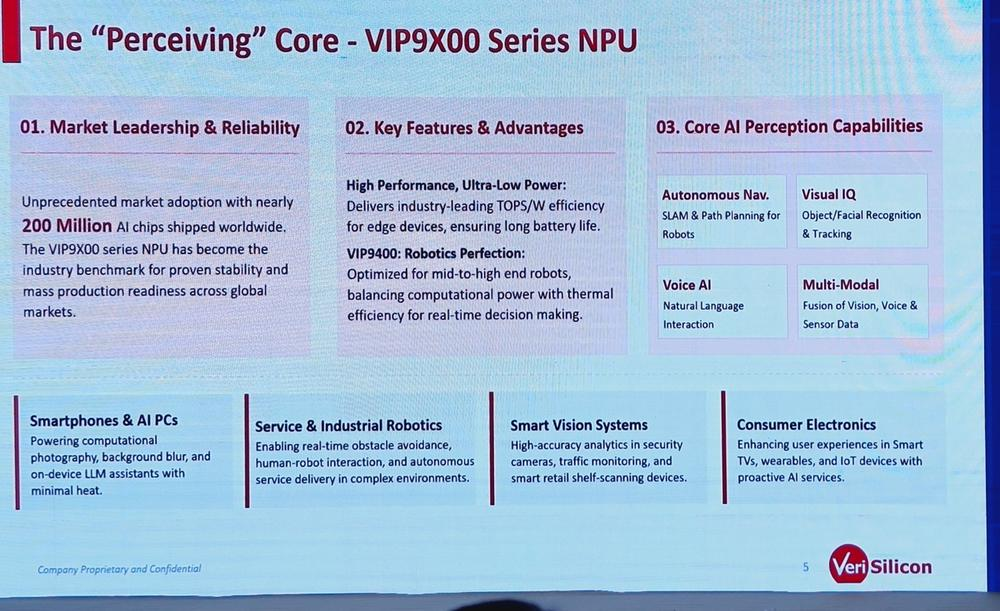
AI大規模言語モデル時代の演算ニーズに対応するため、VeriSiliconは次世代VIP 9000シリーズNPUのアーキテクチャ設計を全面的にアップグレードした。CNN時代のNPU設計と比較して、VIP 9x00シリーズNPUは5つの並列演算エンジンを提供し、大規模言語モデル内の各並列演算ユニットを並列処理することで、演算効率を効果的に向上させ、入力帯域幅を最大限に活用する。データ形式に関しては、VeriSilicon VIP 9x00シリーズNPUは業界のすべての先端AIデータ形式を既にサポートしている。
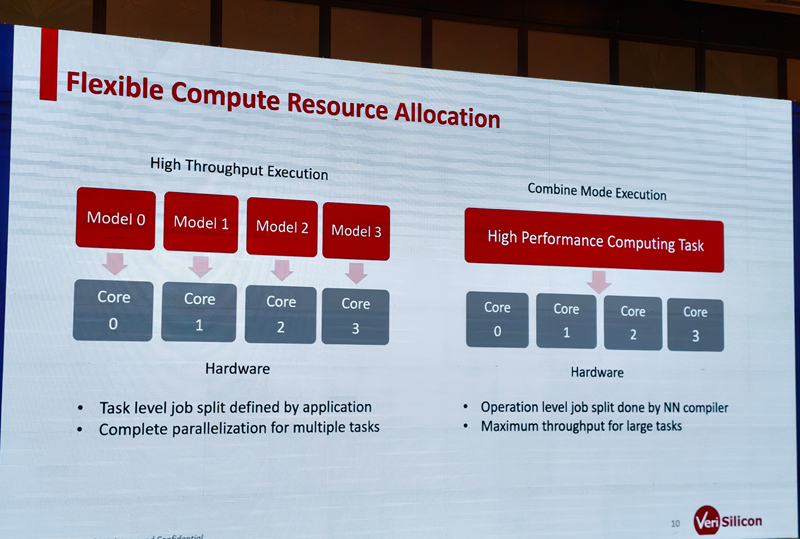
このうちVIP9400はマルチコア連動モードを提供し、より大きな演算能力を提供すると同時に、より柔軟な組み合わせ演算ユニットも提供する。性能がさらに高いVIP9800は8コア連動が可能で、DDRとの協調処理を実現し、帯域幅の最適化と演算能力の向上を両立する。VIP9800はマルチタスク並列モード(複数のモデルを全コアで実行)とシングルタスクのマルチコアパーティションモード(複数のコアで同一モデルを共同処理)を同時にサポートし、前者はマルチタスクシーンに適し、後者は単一タスク処理ニーズに対応する。
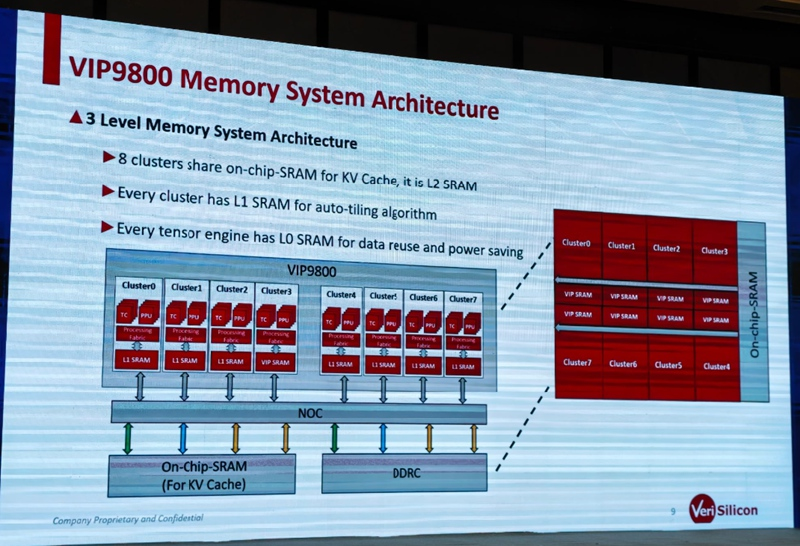
ソフトウェアエコシステムについては、VeriSiliconのNPUは既に各種の主流モデルフレームワークおよび同一フレームワーク内の異なるバリエーションをサポートしており、RuntimeとOfflineの2つのソフトウェアデプロイメントモードを提供し、様々なアプリケーション開発ニーズに対応する。
出荷規模において、VeriSiliconのNPU IPは市場でリーダー的地位にあり、量産チップは既に2億個近くに達し、四半期ごとに量産チップ数は増加し続けている。用途別に見ると、VeriSiliconのNPU IPはスマートフォンやAIPCで製品化されており、特に中国国産AIPCチップではほぼ全てがVeriSiliconのNPU IPを採用している。また、産業用ロボットおよびサービスロボット分野でも、VeriSiliconのNPU IPは顧客に採用されている。
CC10000シリーズGPGPU IPの性能が50%向上
GPGPU IPに関しては、TensorとVectorの演算能力構成は顧客のニーズに応じて柔軟に設定可能だ。同時に、VeriSiliconは次世代CC10000シリーズのGPGPU IPも発表しており、300-500TOPSの演算能力範囲において、PPA(性能、消費電力、面積)は前世代と比較して約40%〜50%向上しており、大規模な演算能力を必要とするロボットやエッジサーバー製品に適している。
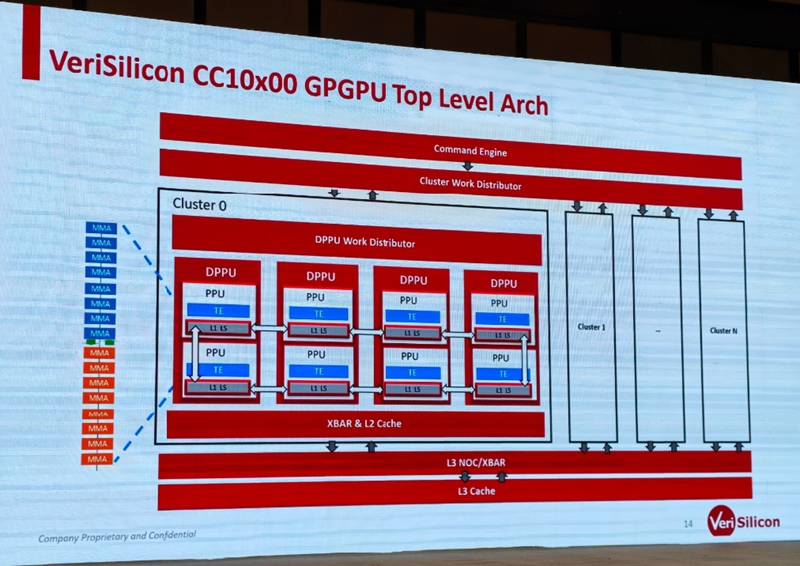
また、CC10000シリーズGPGPU IPは前世代のソフトウェアアーキテクチャとの互換性を維持するだけでなく、顧客の様々なソフトウェアスタックおよびCUDAソフトウェアスタックにも対応可能だ。張氏によると、VeriSiliconは複数のパートナーとCC10000シリーズGPGPU IPの製品化を推進している。
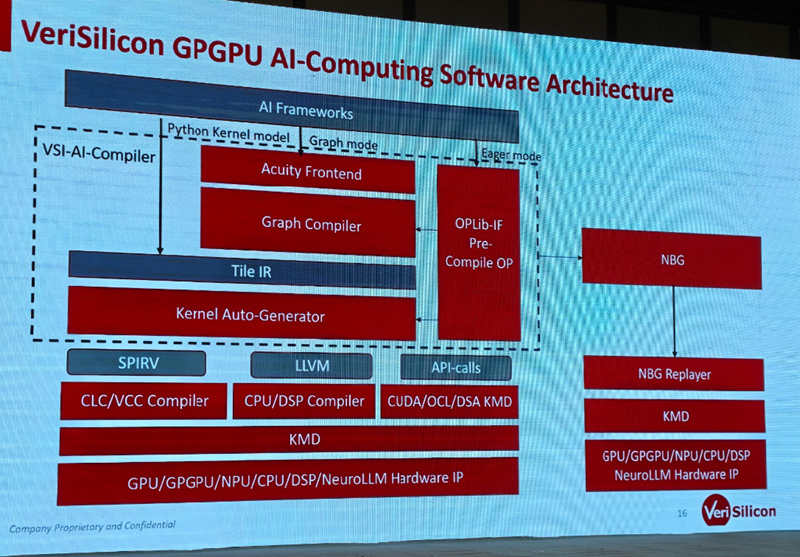
ソフトウェアプラットフォーム面では、VeriSiliconはワンストップで統一されたAIコンパイラを構築している。このAIコンパイラは、上位層で様々なAIフレームワークに接続可能で、下位層では異なる演算能力のIPに適合し、中間層ではモデル最適化およびハードウェアに依存しないソフトウェア抽象化を担当し、ソフトウェアとハードウェアの分離を実現する。
これはすなわち、顧客のAIチップが世代交代する際に、VeriSiliconの新しい演算能力、より優れた電力効率のIPソリューションにアップグレードするだけで、従来のソフトウェアスタックおよびソフトウェアエコシステムを引き続き利用できることを意味し、顧客のソフトウェアにおける重複開発や関連する研究開発投資を大幅に削減し、チップのイテレーションから上市までの期間も短縮する。特に大規模言語モデルや小規模言語モデルの進化が速い場合、顧客のソフトウェアへの投資は非常に大きいため、統一されたソフトウェアスタックを利用できれば、顧客のソフトウェア投資を大幅に削減できる。
システムレベルのソリューション
VeriSiliconはNPU IPおよびGPGPU IPソリューションに加えて、SoCソリューションも有している。VeriSiliconのIPチームとSoCチームは一連のチップアーキテクチャリファレンスデザインを実施しており、顧客自身のSoC開発をサポートすることも、VeriSiliconの設計サービスを利用して顧客にトータルソリューションを提供することも可能だ。
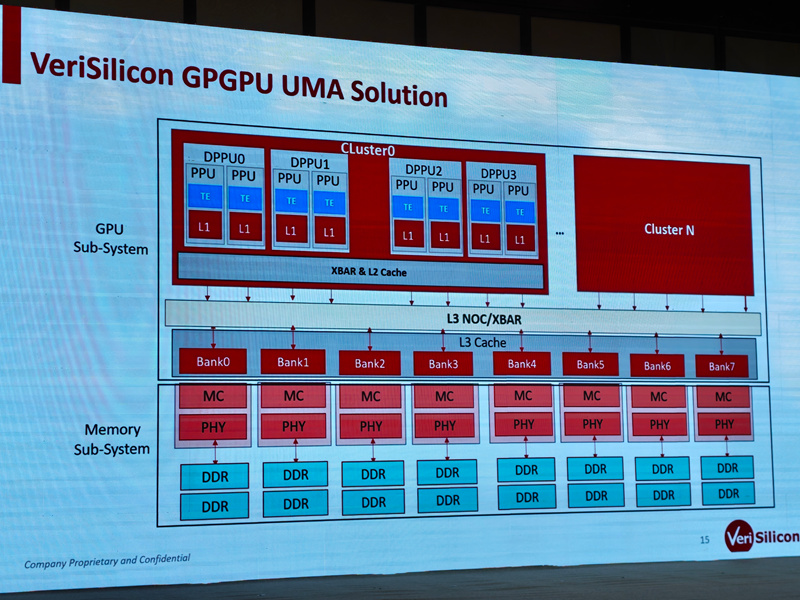
同時に、VeriSiliconはCC10000シリーズのDie to Die相互接続およびChip To Chipソリューションも発表している。顧客が同様のチップや仕様がほぼ同じで演算能力が異なるチップを必要とする場合、VeriSiliconが提供するこのプラットフォーム上で迅速にハードウェアとソフトウェアを実装することができる。
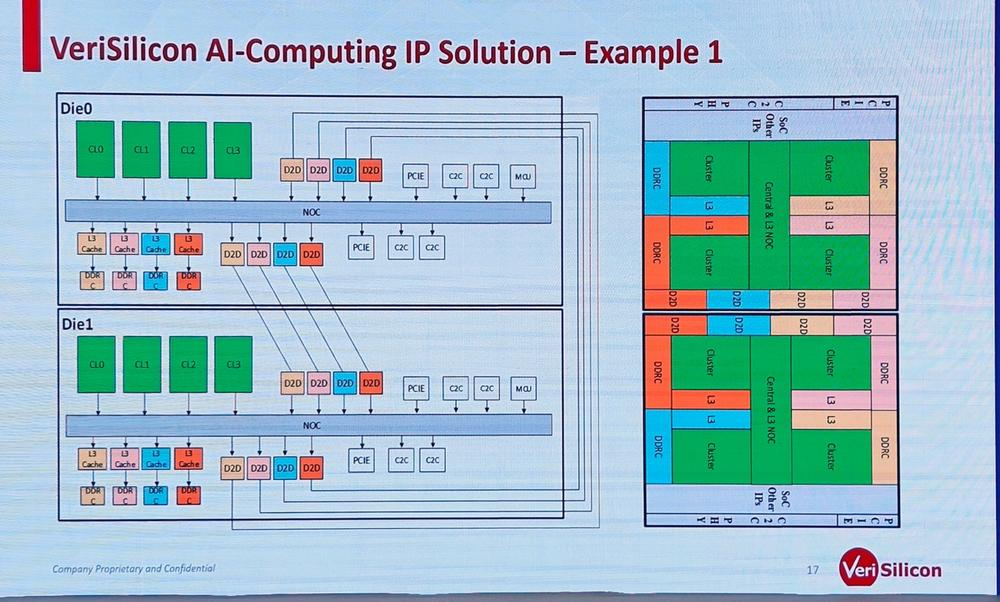
情報によると、VeriSiliconは現在4つのDieソリューションを完了しており、3Dスタッキングをサポートしている。VeriSiliconのGPGPUソリューションおよびSoCソリューションは、DDRまたはHBMのいずれかの選択をサポートしており、DDRの帯域幅配分、Die to Dieの配分、およびChip to Chipの配分において、VeriSiliconは優れたソリューションを提供している。
セミナーの最後に、張慧明氏は「より多くのパートナーがVeriSiliconのGPGPU IPを採用し、ロボットAIコンピューティングプロセッサの発展を共に推進することを期待している」と示した。
(原文:https://www.icsmart.cn/107048/)