

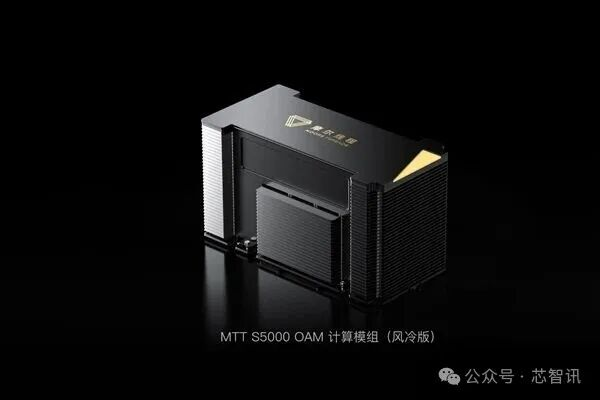
中国GPU大手「モアースレッド(摩爾線程)」、GPU「MTT S5000」のパラメータを公開、単一GPU演算性能が1000Tを突破
このほど、モーレスレッド(Moore Threads)はフラッグシップ製品GPU「S5000」の詳細パラメータを初公開した。「平湖(Pinghu)」アーキテクチャをベースに、単GPUのFP8演算性能は1000Tを突破し、80GBのメモリ、1.6TB/sの帯域幅を実現した。FP8からFP64までの全精度をカバーしている。さらに、トレーニング精度はH100に迫り、その差はわずか1%未満。
1.コアパラメータの比較:1000TFLOPSと全精度カバー
MTT S5000は設計当初から「トレーニングと推論の一体化」を実現するフル機能基盤として位置づけられており、そのハードウェアパラメータは極めて強力な競争力を示している。
演算性能:単一GPU「S5000」のAI演算性能(FP8)は最大1000TFLOPS(1 PFLOPS)に達している。この数値は、中国国産GPUの単一GPUのスループットにおいて国際的な主流製品とほぼ同じ水準に達したことを示している。
演算精度:本GPUはFP8、BF16、FP16からFP32、FP64に至るまでの全精度計算をサポートする。業界内の実測によれば、S5000は計算精度の面でNVIDIA H100を凌駕し、高精度演算能力においては同社の最新Blackwellアーキテクチャに迫る。
メモリ仕様:80GBのメモリを搭載し、メモリ帯域幅は1.6TB/sに達する。この仕様により、超大規模パラメータモデル(DeepSeek-V3など)を処理する際に、データ読み取りがボトルネックになることを防ぐ。
相互接続帯域幅:GPU間の相互接続帯域幅は784GB/sに達し、数万枚のGPU規模での効率的な協調処理をサポートし、分散トレーニングの効率を大幅に向上させる。
2.アーキテクチャの優位性:第4世代MUSAとネイティブFP8エンジン
S5000の卓越したパラメータ性能の背景には、モーレスレッドが独自に開発した第4世代MUSAアーキテクチャ「平湖」がある。
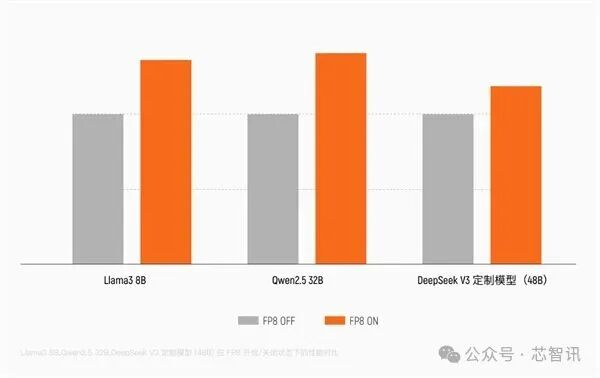
国内で初めてFP8精度をネイティブサポートするトレーニング用GPUとして、S5000にはハードウェアレベルのFP8 Tensor Coreアクセラレーションユニットが内蔵されている。従来のBF16/FP16と比較して、FP8はデータバスの幅を半分にすることで、メモリ帯域幅への負荷を50%削減し、理論上の計算スループットは倍増する。実証テストでは、DeepSeekやQwenなどの最先端モデルアーキテクチャにおいて、S5000のFP8エンジンはトレーニング性能を30%以上向上させる。
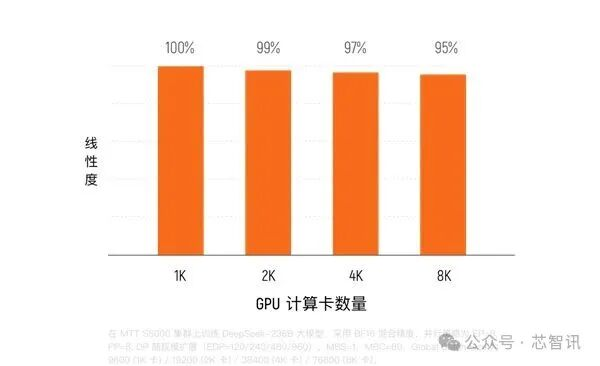
さらに、S5000には独自開発のACE(自動計算エンジン)技術が搭載されている。この技術は複雑な通信タスクを計算コアからオフロードし、計算と通信の競合のない完全な並列処理を実現する。実測では、64GPUから1024GPUに拡張しても、システムは常に90%以上の線形拡張効率を維持し、演算性能パラメータを実戦的な性能に十分に転換できることを保証している。
3.性能実測:高精度トレーニングでH100に対抗
実測において、S5000のパラメータ優位性は顕著な効率向上として現れている。
H20との比較:インターネット企業によるエンドツーエンドのタスクテストでは、S5000の総合性能はNVIDIA H20の約2.5倍だった。
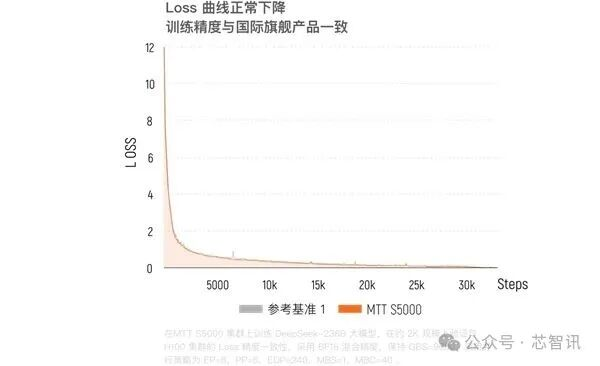
H100との比較:北京智源人工智能研究院(Beijing Academy of Artificial Intelligence)がS5000の数千枚のGPUクラスタを用いて具身知能モデル「RoboBrain 2.5」をトレーニングしたところ、そのトレーニング損失値(loss)はH100クラスタとの差がわずか0.62%で、主要指標の誤差は数パーミルにとどまり、トップレベルの演算性能への高度な追従を実現した。
特筆すべきは、S5000が推論シナリオでも優れた性能を発揮している点だ。例えば2025年12月、モーレスレッドはSiliconFlowと協力し、MTT S5000を用いてDeepSeek-V3 671B(フルパラメータ版)の深度適応と性能テストを完了した。
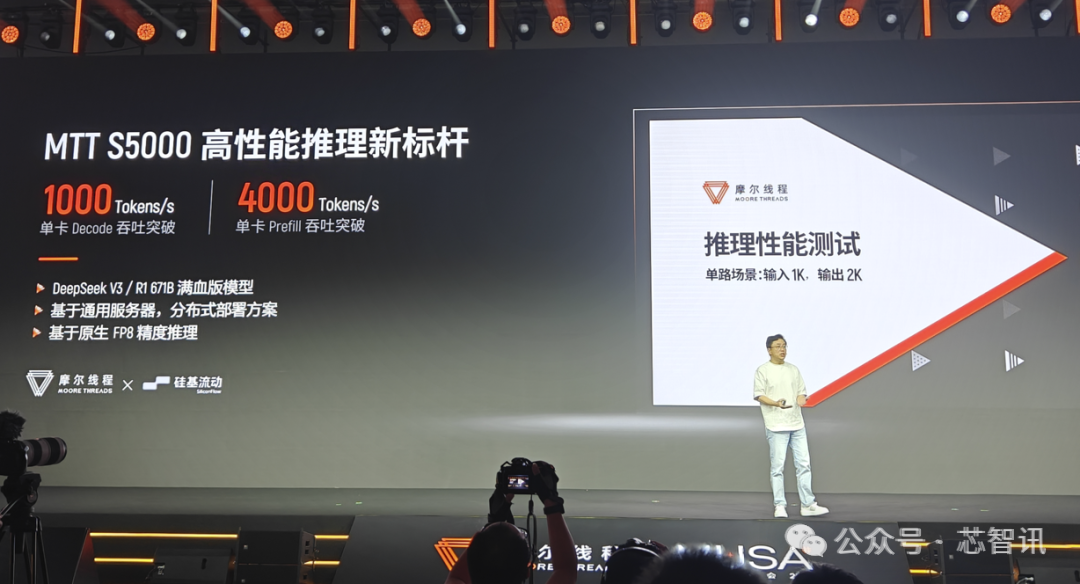
実測では、S5000の単GPUPrefillスループットは4000トークン/秒、Decodeスループットは1000トークン/秒を超え、中国国産GPUの推論記録を更新した。
4.エコシステム展開:智譜GLM-5のDay-0適応検証
S5000パラメータの強力さは、最終的には最先端モデルを支える能力に如実に表れる。先日、智譜(Zhipu AI)が大規模モデル「GLM-5」を正式発表した当日、モーレスレッドはMTT S5000が同モデルのDay-0全行程適応と検証を完了したことを発表した。
MUSAフルスタックソフトウェアプラットフォームによるSGLang、PyTorch、vLLMなどの主要フレームワークへのネイティブ適応により、S5000はCUDAエコシステムのコードを「ゼロコスト」で移行できるだけでなく、80GBメモリと1.6TB/s帯域幅という強力なパラメータ基盤により、GLM-5などの数兆パラメータモデルの迅速な反復開発を支える、堅牢な国産演算処理基盤を提供している。
(原文:https://www.icsmart.cn/101858/)