

张慧明:从NPU/GPGPU IP到SoC,芯原提供一站式机器人大脑AI解决方案!
7月3日,在“芯原股份具身机器人专题技术研讨会”上,芯原股份GPU/NPU产品高级副总裁张慧明以“机器人之脑——高效强大的AI计算处理器”为主题,系统介绍了芯原在AI计算处理器领域的技术布局。张慧明指出,芯原可以为客户提供一站式机器人大脑AI解决方案,最新推出CC10000系列GPGPU IP适合有大AI算力需求的机器人、边缘服务器产品,正在与跟多个合作伙伴推进该IP的产品化落地。
NPU与GPGPU双线布局
机器人是一个复杂的系统,需要处理复杂的感知、决策及交互,核心就是高性能的AI处理器——即“机器人大脑”。张慧明指出,芯原可以提供基于NPU和GPGPU的AI IP解决方案,并与设计服务团队协作提供AI SoC整体解决方案。
芯原的NPU和GPGPU拥有多年发展历史,从第一代图形显卡开始,到2016年做NPU扩展指令集,再到2017年推出第一款NPU IP,芯原的GPU相关技术已有近20年的积累,NPU也有将近10年的历史。芯原一贯推行统一的架构方案——统一的软件解决方案和统一的硬件解决方案。
芯原的NPU和GPGPU的核心区别在于算力配比:NPU的Tensor(张量)处理能力较大,而GPGPU的Vector(向量)处理能力与Tensor持平,可以实现Vector和Tensor协同工作的处理能力。
VIP9X00系列NPU IP全面升级
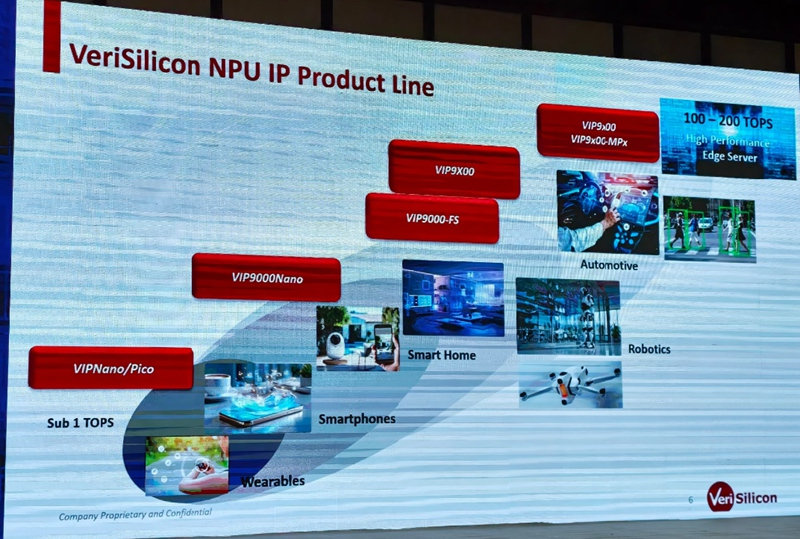
芯原NPU IP的产品系列,包括VIP Nano系列、VIP9000-FS系列、VIP9X00系列等,覆盖了从1TOPS以下到数百TOPS,可满足不同的性能层级需求。
面对AI大模型时代的算力需求,芯原在新一代的VIP 9000系列NPU架构设计上进行了全面升级。相比CNN时代的NPU设计,VIP 9x00系列NPU提供了5个并行计算引擎,可以并行处理大模型中的各个并行计算单元,有效地提升了计算效率并充分利用了输入带宽。在数据格式方面,芯原VIP 9x00系列NPU也已支持业界所有先进的AI数据格式。
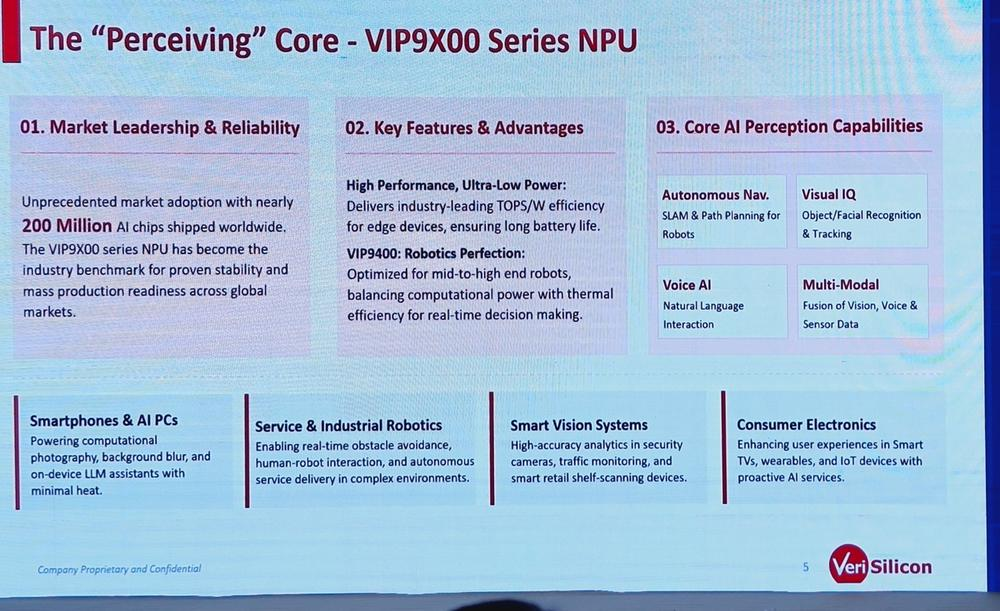
其中,VIP9400可提供多核联动模式,既可以提供更大的算力,也可以提供更灵活的组合运算单元。性能更强的VIP9800则可以做到八核联动,并与DDR实现协同处理,既优化带宽又提升算力。VIP9800可同时支持多任务并行模式(多个模型跑在所有核上)和单任务在多核Partition模式(多核共同处理同一模型),前者适合多任务场景,后者则可满足单一任务处理需求。
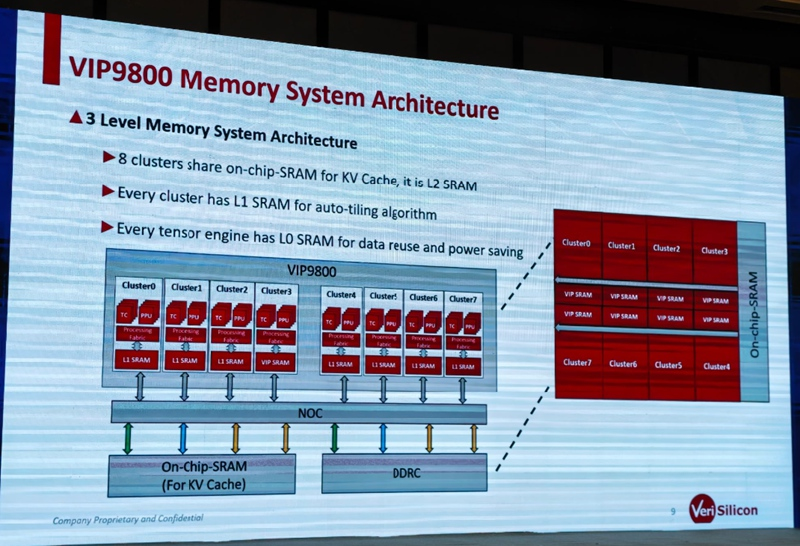
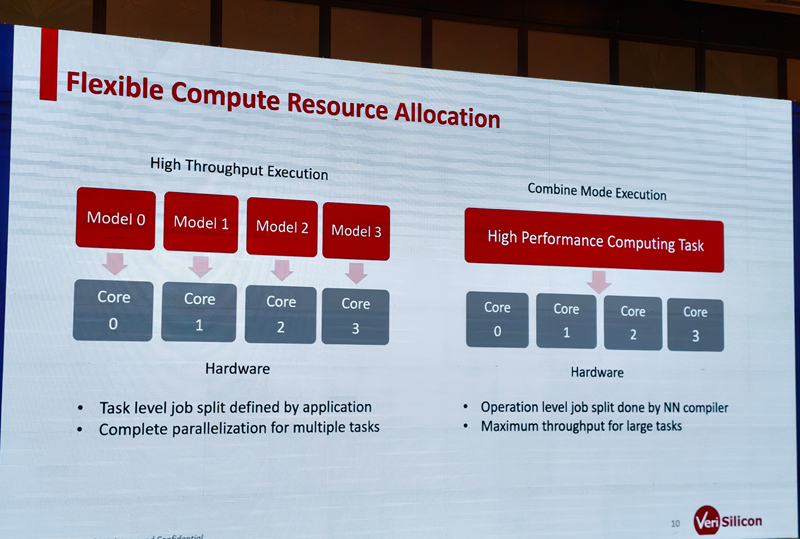
在软件生态方面,芯原的NPU已支持各种主流模型框架及同一框架下的不同变种,并提供Runtime和Offline两种软件部署模式,满足不同应用开发需求。
在出货规模方面,芯原NPU IP在市场上处于领先地位,已接近2亿颗量产芯片,且每一季度量产芯片数量都在持续增加。从应用来看,芯原的NPU IP在智能手机、AIPC上都有产品落地,特别是在国产的AIPC芯片方面,基本都有采用芯原的NPU IP。此外,在工业机器人及服务机器人领域,芯原的NPU IP也获得了客户的采用。
CC10000系列GPGPU IP性能提升50%
在GPGPU IP方面,Tensor和Vector的算力配置可以根据客户的需要进行灵活配置。同时,芯原也推出了新一代CC10000系列的GPGPU IP,在300-500TOPS算力范围内,PPA(性能、功耗、面积)相比上一代提升了约40%-50%,适合于有大算力需求机器人、边缘服务器产品。
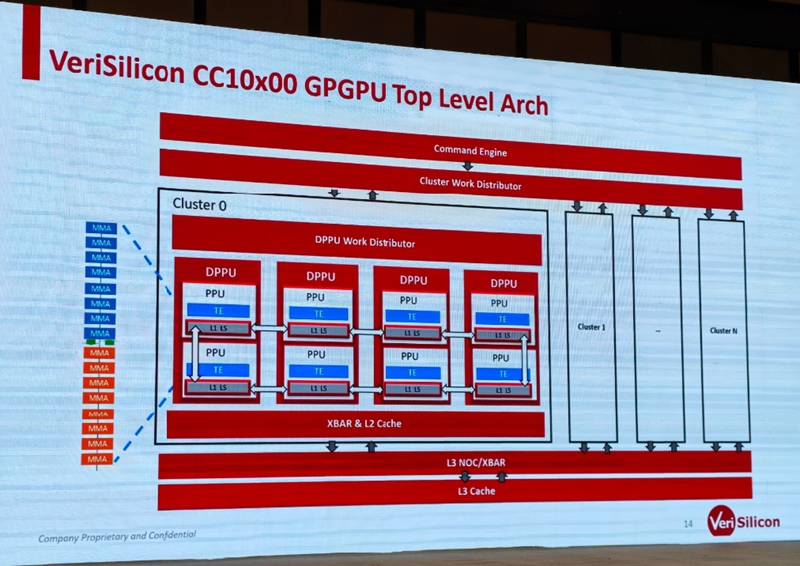
同时,CC10000系列GPGPU IP不但兼容了前一代的软件架构,还可适配客户的各种软件栈以及CUDA软件栈。据张慧明透露,芯原正在与跟多个合作伙伴推进CC10000系列GPGPU IP的产品化落地。
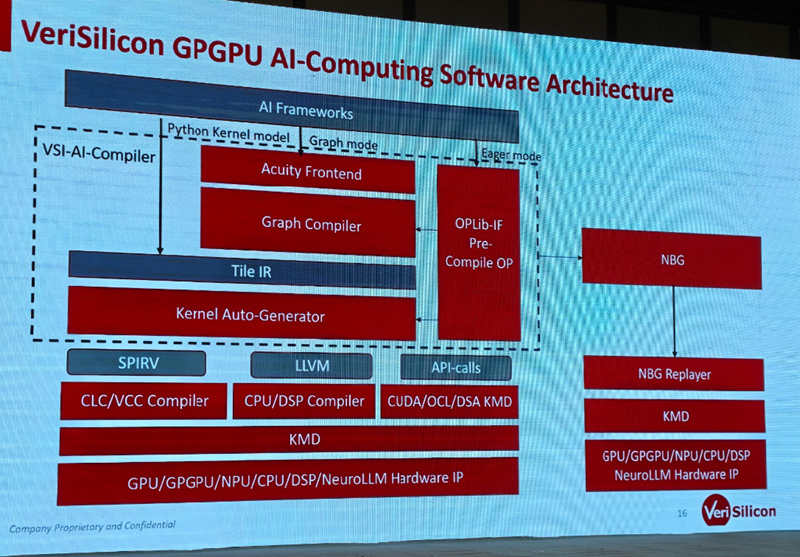
在软件平台方面,芯原搭建了一套一站式的、统一的AI计算编译器。该AI编译器上层可以对接各种AI框架,下层则可以适配不同算力的IP,中间层则负责完成模型优化及与硬件无关的软件抽象,从而实现软件与硬件的解耦。
这也意味着,当客户AI芯片升级换代的时候,只需升级到芯原新的算力、能效更好的IP解决方案之后,可以继续沿用之前的软件栈和软件生态,极大的减少了客户在软件方面重复开发和相关研发投入,也缩短了芯片迭代到上市的周期。特别是在大模型或小模型演进比较快的时候,客户在软件上的投入是非常巨大的,如果可以用统一的软件栈,可以大幅减少客户在软件的投入的投入。
系统级解决方案
芯原除了有NPU IP和GPGPU IP解决方案也有SoC解决方案,芯原的IP团队和SoC团队也做了一系列的芯片架构参考设计,既可以支持客户自己的SoC研发,也可以用芯原的设计服务来帮助客户提供整体的解决方案。
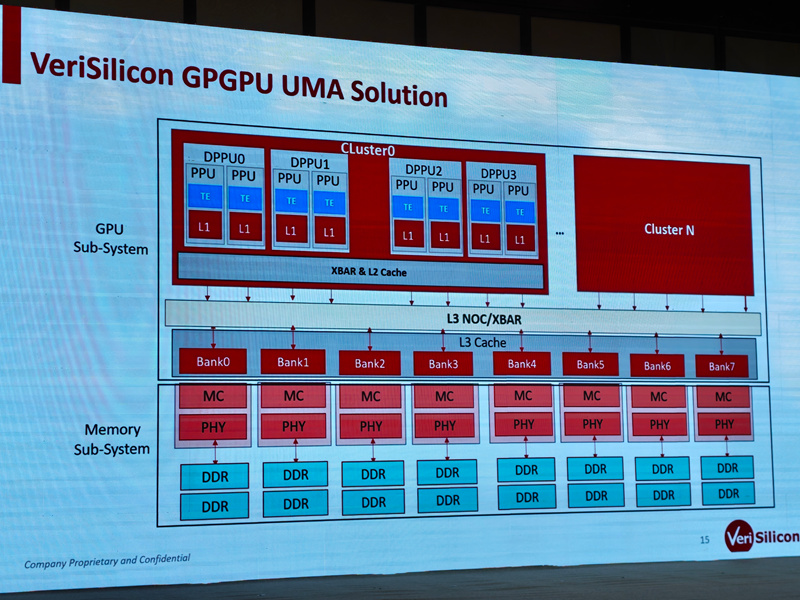
同时,芯原还推出了CC10000系列的Die to Die的互联及Chip To chip的方案。如果客户需要做类似的芯片或者是规格差不多、算力不同的芯片,则可以在芯原提供的这个平台上实现很快的硬件和软件的落地。
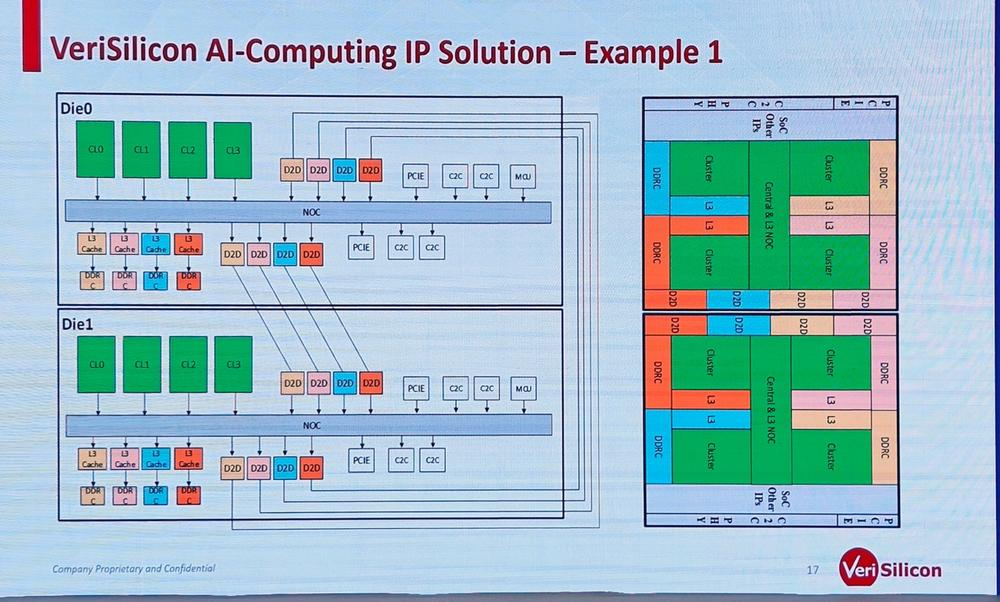
据介绍,芯原目前已经做了四个Die的方案,可以支持3D堆叠。芯原的GPGPU解决方案和SoC方案,既可以支持选用DDR、也可以选用HBM,在DDR的带宽配比上及Die to Die的配比上、以及Chip to Chip的配比上,芯原都有比较好的解决方案。
张慧明最后表示,希望更多合作伙伴到芯原来选用我们的GPGPU IP,共同推动机器人AI计算处理器的发展。
(原文:https://www.icsmart.cn/107048/)