

麒麟2026实测数据曝光:晶体管密度大涨55%,功耗与温度大降!
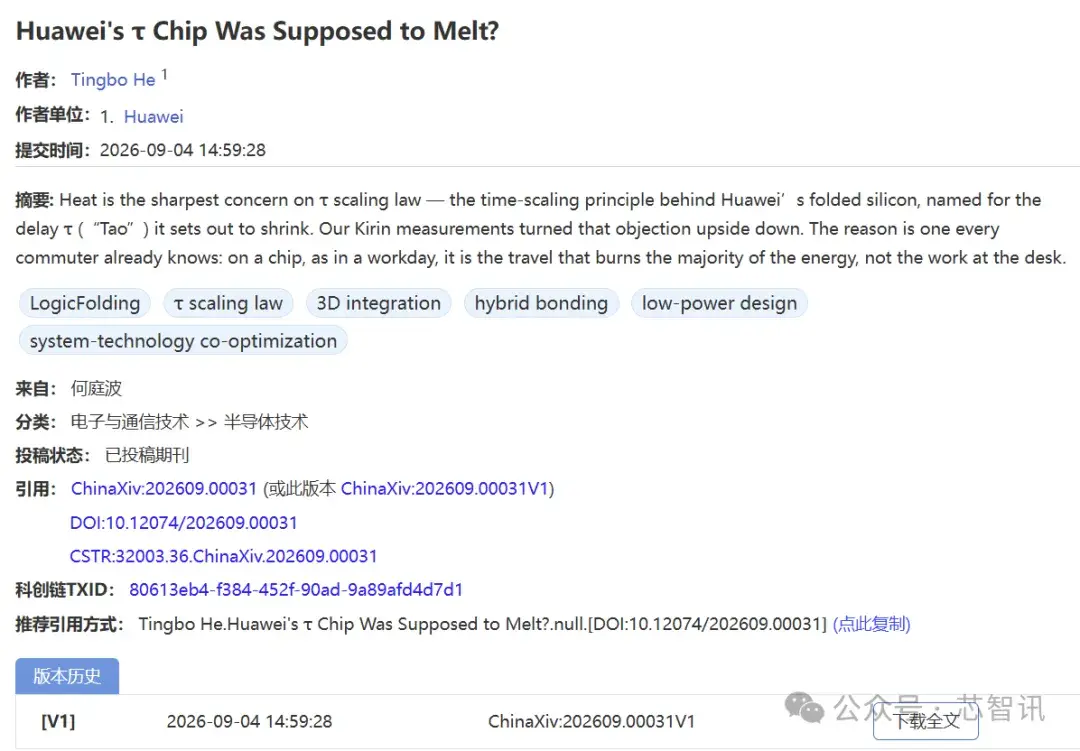
2026年9月4日,华为半导体业务部总裁何庭波在中国科学院科技论文预发布平台ChinaXiv上发布了题为《Huawei's τ Chip Was Supposed to Melt?》的论文,首次公开了基于“韬(τ)定律”打造的麒麟2026芯片实测数据。论文以实际结果回应了外界对于该技术发热隐患的质疑,标志着“韬定律”在短短40天内,完成了从理论框架到工程实证的关键跨越。
论文数据显示,采用“逻辑折叠”(LogicFolding)技术的麒麟2026芯片,其晶体管密度从上一代平面架构麒麟9030 Pro的约每平方毫米1.55亿个,跃升至2.38亿个,提升幅度高达55%。这一增幅,相当于过去依靠传统工艺微缩三年才能达到的水平。
更令行业关注的是其功耗表现。在同等性能的测试条件下,麒麟2026的NPU功耗下降了66%,GPU功耗下降了58%,CPU性能大核功耗下降了41%。这意味着在晶体管数量大幅增加的同时,完成相同任务时芯片的工作温度反而更低,直接颠覆了“密度提升必然导致功耗飙升”的传统认知。
论文解释了这一反常识现象的核心原因:现代芯片绝大部分能耗并非消耗在晶体管本身的逻辑运算上,而是消耗在数据通过金属走线搬运的过程中,如同上班族通勤能耗远大于工位办公。
“逻辑折叠”技术通过将原本在平面上延伸的长距离走线,折叠为上下层之间的短距离垂直连接,显著缩短了信号传输路径。走线缩短直接削减了占据功耗大头的互连电容开销,并使得电路可以在更低电压下工作。由于动态功耗与电压平方成正比,这一变化带来了幅度更大的功耗收益。
论文特别指出,τ(韬)是时间缩放定律,其本身并不等同于天然低功耗。折叠架构既可以低电压低温运行,也可以拉高频率换取更强性能。麒麟2026之所以能在功耗上取得巨大收益,是工程师在获得“逻辑折叠”带来的时间裕量后,主动将其转化为电压和功耗降低的结果。
在追求极限性能的Turbo模式下,麒麟2026的NPU算力最高可达70 TOPS,相比前代提升141%。这印证了华为的迭代路径:每一代芯片将折叠带来的时间红利,转化为功耗或性能收益,循环往复,持续推动芯片进步。
此前的7月份,何庭波已在ChinaXiv上发布了“韬(τ)定律”的V2版本论文,系统阐述了这一后摩尔时代的缩放理论体系。而9月4日更新的这篇论文,则聚焦于工程实证,用麒麟2026的量产数据验证了理论的正确性。
截至发稿,该论文在ChinaXiv平台上的点击量已超28.8万次,下载量超6万次。据悉,麒麟2026和2027均已完成流片。今年秋季,搭载麒麟2026芯片的新机将正式问世。